
基于硬件加速卡的 OPC 软服务器部署成本效益分析:直击传统边缘网关痛点
采用专用加速卡可削减60%以上CPU开销与授权许可费,使边缘网关在千点级高频采集场景下实现毫秒级稳定响应,综合TCO显著降低。
当前产线数字化改造中,大量企业仍沿用通用x86工控机运行OPC DA或UA软服务器。面对成百上千个PLC寄存器轮询与多源异构设备接入,宿主机主频占用率常年飙升至90%以上。高昂的Windows Server基础授权费、按Tag数量阶梯计费的商业许可证续订,以及由此引发的内存泄漏与实时性抖动,已成为数据断链的核心隐患。尤其在高频闭环控制链路中,软件协议栈的上下文切换延迟导致时间戳错位,直接制约了MES执行系统的排产精度。
面对DA向UA迁移与边缘侧协议融合的双重压力,一线工程师亟需一种低耦合、高并发的底层算力支撑方案。传统“全栈软件处理”模式在扩展性上遭遇天花板,强制扩容硬件不仅推高初始投资,还会增加机房承重与散热运维负担。
- 网络层瓶颈:通用网卡驱动在每秒万级小包收发时易触发中断风暴,导致协议解析队列阻塞。
- 内存管理缺陷:频繁的对象序列化与反序列化操作引发GC停顿,实时线程优先级被操作系统抢占机制打乱。
- 合规成本攀升:等保2.0与IEC 62443标准要求强化边界隔离,纯软网关难以在不牺牲吞吐量的前提下完成策略卸载。
基于硬件加速卡的 OPC 软服务器部署成本效益分析:架构重构与方案落地
「基于硬件加速卡的 OPC 软服务器是指将Modbus/TCP、PROFINET及OPC UA二进制编码等协议解析、标签映射与队列调度卸载至专用FPGA或ASIC芯片,以释放宿主机CPU资源的边缘计算架构。」该设计彻底改变了传统应用层的处理逻辑。
工程实施通常遵循标准化部署流程。物理层需选用PCIe x4或Mini PCIe插槽加速模块,直连交换机光口实现无内核绕过技术,数据直达加速卡DMA控制器。协议栈硬化环节在固件侧固化OPC UA PublishSubscribe模型与OPC DA读写指令集,支持动态地址块划分与断线重连自动恢复。软服桥接阶段仅保留轻量级配置UI与历史归档接口,宿主端通过共享内存环形缓冲区与加速卡交互,规避TCP/IP协议栈重复校验开销。
为保障极端工况下的数据连续性,现场集成必须配套严格的工控机系统加固规范。这包括宽温商用级主板选型、三防涂层喷涂、双电源冗余设计以及EMI滤波阵列部署,确保在强电磁干扰环境下硬件不降频。某汽车零部件厂的实地验证表明,该架构同样适用于复杂物流场景。在立体仓库堆垛机位置同步 OPC 通信实现过程中,原有线槽扫描周期为200ms,引入加速卡后轮询延迟压降至8ms以内,彻底消除了因CPU满载导致的货位坐标漂移现象,且无需改造现有安全PLC固件。
基于硬件加速卡的 OPC 软服务器部署成本效益分析:实测数据与选型指南
经过连续七十二小时满负荷压力测试,软硬协同方案的效能跃升具备明确的量化指标。与传统平台部署同类软服对比,核心差异集中在以下维度:
- 算力成本折抵:单节点CPU平均负载从85%降至12%,无需额外采购高性能Server级工控机,硬件CAPEX节约约35%。
- 许可费用归零:免除按Tag数量阶梯计费的商业授权模式,一次性投入即可解锁十万级虚拟点位,OPEX长期摊销曲线呈断崖式下降。
- 实时性突破:微秒级中断响应替代操作系统级任务调度,OPC UA PubSub发布间隔稳定保持在10ms,丢包率低于0.01%。
选型时需重点核对三项硬性参数。首先核验PCIe通道数与带宽是否匹配目标采样频率,双通道X8架构更适合千兆光口环境。其次检查内置RAM容量能否缓存突发流量冲击,建议不低于4GB以防数据溢出。最后确认SDK是否开放C/C++ API以对接SCADA二次开发框架。对于仅需单向读取的静态监控场景,基础型以太网接口板卡已足够;涉及高频写入与复杂数据类型(如Struct、Array)映射的项目,应优先选择支持多队列并行处理的独立加速模组。
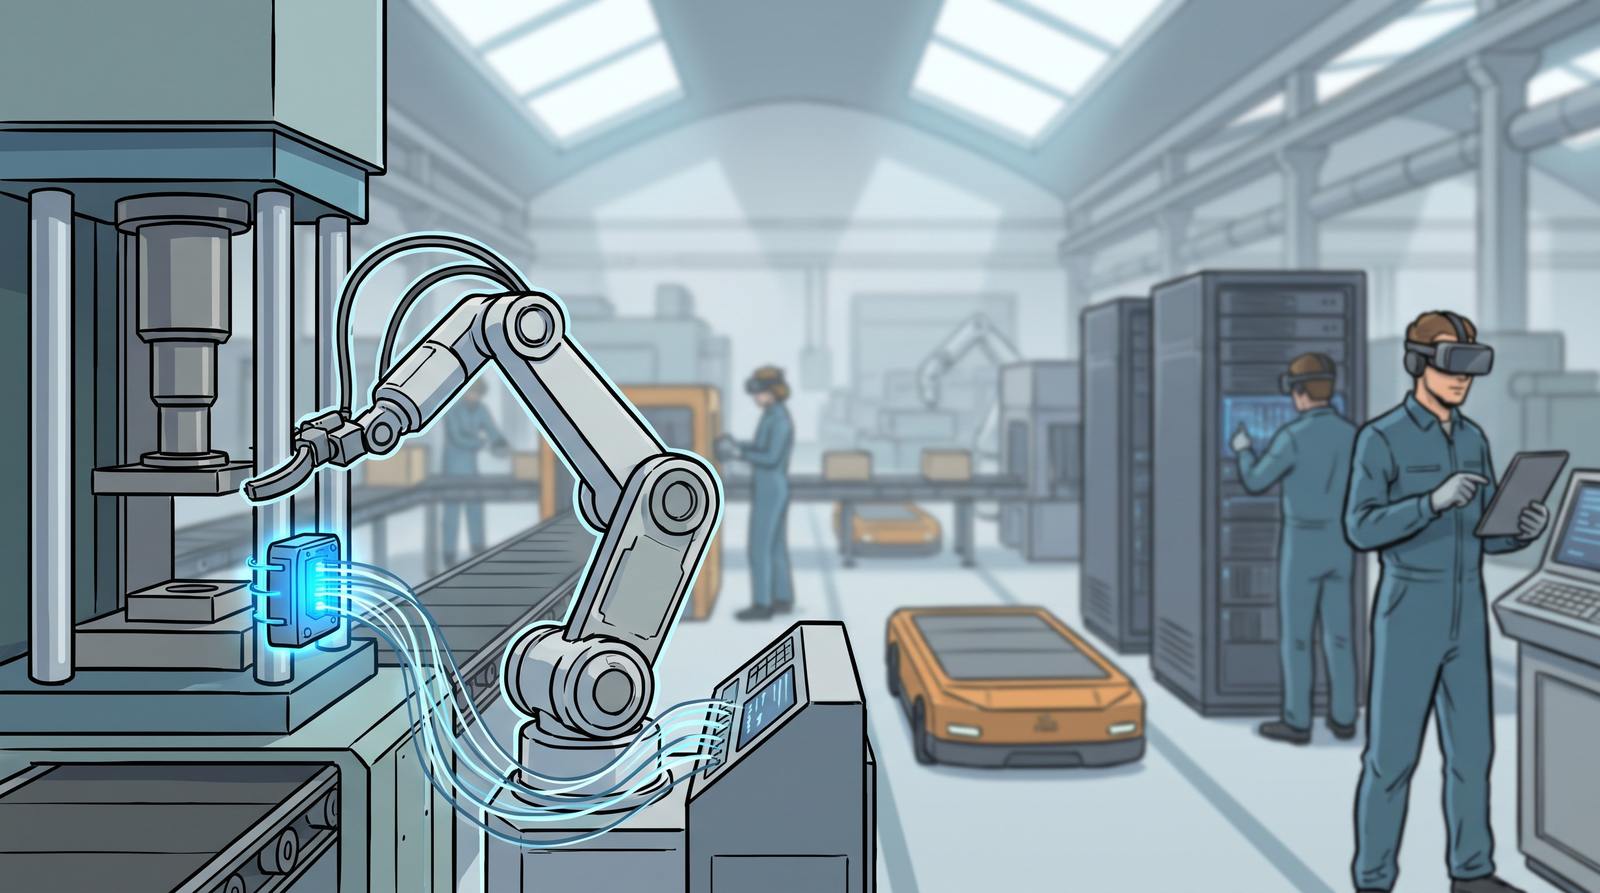
协议转换的演进方向并非无限叠加软件功能,而是通过硬件抽象层将确定性传输交还给物理介质。当采集节点密度与实时性要求突破传统软服承载阈值时,上述架构已成为工业物联网底座的标准配置。
常见问题
加速卡是否兼容老旧PLC的Modbus RTU串口通信?
兼容。主流加速卡提供多路RS-485电口,固件内嵌RTU帧组装逻辑,可直接透传至宿主机或转换为TCP报文输出,无需额外加装串口服务器。
升级OPC UA证书后是否需要重新烧录固件?
不需要。加密套件与X.509证书均托管于宿主操作系统,加速卡仅负责非对称加密运算加速,证书替换通过API热加载即可完成。
如何评估实际项目中的性价比拐点?
当采集点数超过五千或采样周期要求小于二十毫秒时,加速卡方案将跨越盈亏平衡点,其硬件溢价可在十八个月内通过节省的授权与维护工时完全覆盖。

